#63 - Luận giải về LLM và lợi thế cạnh tranh của con người
Đào sâu một chút vào cách hoạt động của LLM, và một số quan điểm về những thứ bạn vẫn có thể làm tốt hơn so với chúng.

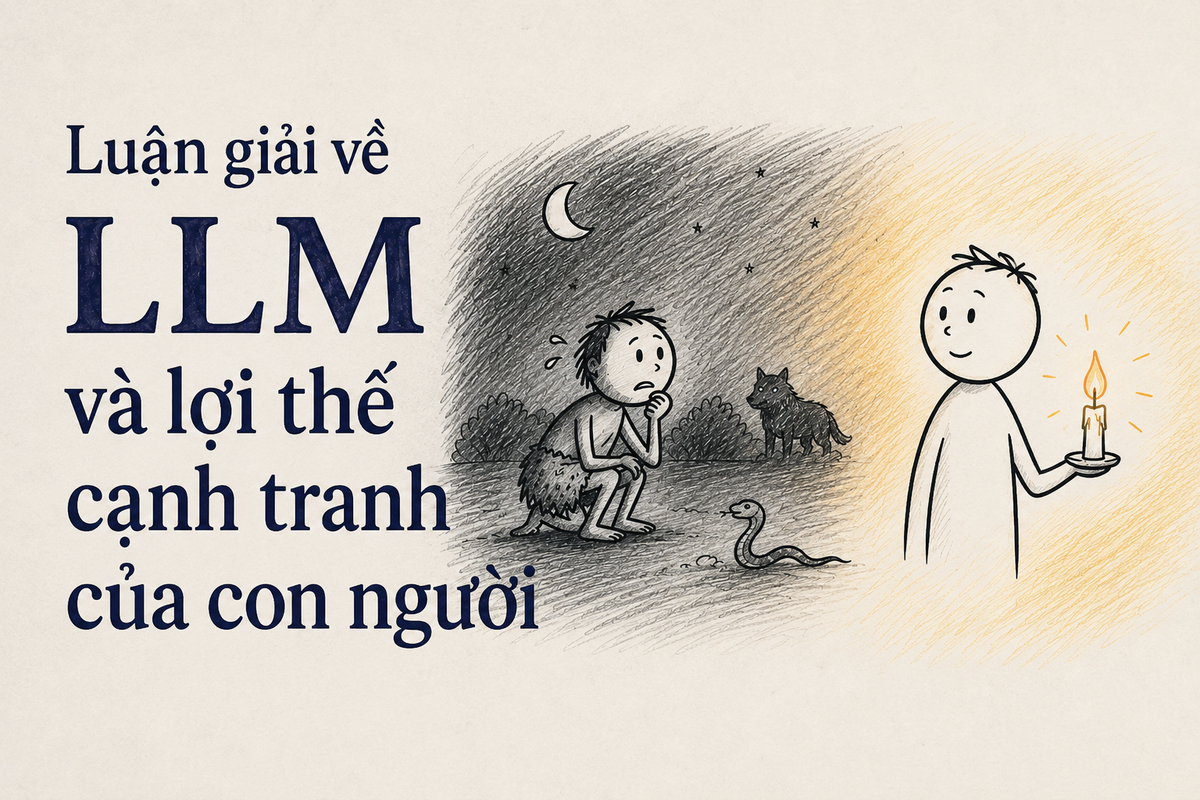
Nhắm mắt lại và tưởng tượng rằng bạn đang sống cách đây khoảng 2 triệu năm. Mặt trời đã hoàn toàn xuống núi, và bạn không thể nhìn thấy bất cứ thứ gì trong màn đêm. Nhân loại vẫn cần thêm tầm 500,000 năm nữa trước khi ai đó khởi tạo được ngọn lửa đầu tiên. Lụm cụm trong bóng tối, bạn không biết có một con sói bụng đói cồn cào nào đang mai phục, hay có con rắn độc nào đang lườn bò quanh đây không. Đối diện với sự bất định, cơ thể của bạn được đẩy vào trạng thái cảnh giác cao độ.
Không ai biết chính xác con người sống như thế nào trước khi có lửa, nhưng chắc tổ tiên chúng ta cũng đầy ắp nỗi âu lo và thấp thỏm trong bóng đêm. Không chỉ đơn thuần là một cảm giác bất định, mà là đó là cảm giác khi đối diện với sự bất định. Bộ não của con người khao khát sự kiểm soát, bởi lẽ sự sinh tồn của cá thể và chủng loài phụ thuộc vào việc điều khiển được môi trường xung quanh. Sự bất định đe dọa khao khát đấy, nên chúng ta thường xuyên sợ hãi những thứ không biết và không điều khiển được.
Quay nhanh kim đồng hồ đến thế giới ngày nay. Từ lúc ngành công nghiệp đèn điện hình thành, con người không còn sống trong lo lắng mỗi khi đêm về nữa. Nhưng cứ mỗi vài thập kỷ đều xuất hiện những nỗi bất định mới làm cho nhiều người sợ hãi và thao thức giống như 2 triệu năm về trước. Hiển nhiên, sự bất định gần đây nhất chính là AI.
Nỗi sợ này không phải mình tự nghĩ ra, mà từ những câu hỏi đến từ các bạn học viên BPM cũng như trong vòng tròn của mình. Ngoài điểm chung là mọi người đều lo lắng, thì mình thấy đa phần chúng ta vẫn chỉ sợ sệt theo một cách "bản năng". Thay vào đó, chỉ cần cố gắng tìm hiểu sâu hơn một chút về cơ chế hoạt động của AI, thì nhiều chuyện sẽ trở nên tường minh hơn. Mình nghĩ rằng tri thức giống như một ngọn lửa, hiểu biết về một thứ gì đó sẽ khiến con người đỡ sợ hơn.
Với tinh thần đó, bài viết này mình muốn luận giải một cách tương đối chi tiết về LLM và nêu ra một số quan điểm về lợi thế cạnh tranh của con người so với AI.
Sau đây là hai nội dung chính:
- Luận giải về LLM, mà cụ thể là Transformer. Đây là phần chính, cũng là phần dài và chi tiết nhất. Khó để nói chúng ta còn làm được gì hơn LLM khi chưa nói về bản chất của chúng.
- Con người đang làm được gì hơn LLM. Đây là phần quan điểm, mình sẽ dùng những kiến thức được trình bày ở phần đầu để về một vài pattern mà con người vẫn có khả năng làm tốt hơn.
(1) Những kiến thức được trình bày trong đây không phải là sáng tạo của mình, mà đến từ nhiều bộ não tinh hoa của nhân loại. Mình chỉ đóng vai trò tổng hợp và trình bày chúng theo cách mà mình hy vọng là dễ hiểu.
(2) Ngoài ra, bài viết này khá dài (~10,000 từ) và mình có cố gắng giải thích các phương trình trong LLM. Bạn có thể lưu lại rồi khi nào ở trong trạng thái tinh thần phù hợp thì đọc nhé! Mình nghĩ bạn nên đọc trên web thì tốt hơn là trên mobile cho nó đỡ mỏi tay mỏi mắt.
(3) Có những kiến thức và khái niệm mình lược bỏ khỏi bài viết nhằm thu hẹp phạm vi của nó lại. Nếu bạn có cách để mở rộng liên kết chúng lại để đọc giả dễ hiểu, thì hãy để lại comment nhé!
Khi bàn về AI, đa phần chúng ta đang nói đến LLM. Để hiểu được LLM, chúng ta cần hiểu về kiến trúc Transformer - được giới thiệu lần đầu trong paper có tên "Attention is all you need" vào năm 2017.
Kiến trúc Transformer chính là thứ mở đường cho những mô hình GPT đầu tiên rồi sau đó cách mạng hóa cả nền công nghiệp AI nói riêng và mảng công nghệ nói chung. Tuy các mô hình LLM ngày nay có nhiều bước tối ưu hóa hơn, nhưng về bản chất chúng vẫn dùng một dạng kiến trúc Transformer. Nắm được kiến trúc này sẽ giúp chúng ta hiểu hơn về cách mà các mô hình như ChatGPT, Claude hay Gemini có thể mô phỏng được trí thông minh giống như con người.
Trong bài viết này, khi mình nói về AI hay LLM, thì mình đang nói cụ thể về Transformer. Tuy còn những phạm trù khác trong Deep Learning hay trong mảng AI nói chung, mình xin phép sẽ giữ sự tập trung vào LLM/Transformer.
Kiến thức nền tảng
Mình sẽ lướt sơ qua một số kiến thức nền tảng để chúng ta xây dựng intuition nhằm hiểu về bản chất của LLM/Transformer tốt hơn.
- (1) LLMs mã hóa các pattern về thế giới từ dữ liệu training. Về lý thuyết, LLMs được train để dự đoán token tiếp theo. Bài toán này nghe có vẻ đơn giản, nhưng để dự đoán token tiếp theo được tốt, LLM phải học được các mô hình nhân quả nằm chìm ở bên trong dữ liệu. Đây là lý do mà ChatGPT hay Claude lại có vẻ "thông thiên văn, tường địa lý" đến vậy.
- Con người chúng ta mã hóa được các hiện tượng cũng như mối quan hệ nhân quả vào trong câu từ nhằm phục vụ mục đích giao tiếp. Nếu không, chúng ta sẽ không hiểu được câu: "Em bé khóc. Mẹ ẵm nó lên dỗ."
- Rõ ràng tồn tại một mô hình nhân quả ở trong đó việc một em bé nào đó khóc sẽ dẫn đến hành vi dỗ dành của người mẹ (và đọc giả sẽ tự ngầm định luôn "mẹ" ở đây chỉ đến mẹ của đứa bé chứ không phải bất kỳ người mẹ random nào).
- LLM được huấn luyện dựa trên hàng triệu triệu điểm dữ liệu ngôn ngữ mà bên trong chúng mã hóa những quy luật, mối quan hệ, định nghĩa, khái niệm về thế giới, và chúng dần học cách mã hóa những pattern đó dưới dạng các con số trong network. Cơ chế này mô phỏng công năng, nhưng không hẳn sát với cách não bộ con người thật sự học (predictive coding là một cơ chế khác có vẻ gần hơn).
- (2) Token là đơn vị được nhỏ nhất LLMs xử lý ở đầu vào cũng như ở đầu ra. Cách hiểu sau đây nó không chính xác 100%, nhưng nó gần đúng và đủ hữu dụng: bạn có thể xem mỗi token như một từ ở trong câu. Khi bạn đưa cho ChatGPT hay Claude một câu prompt, từng từ đơn lẻ ở trong prompt đó có thể xem như một token.
- (3) LLMs xử lý tất cả tokens song song chứ không tuần tự. Trái với việc LLM dự đoán và output ra từng token đơn lẻ, chúng xử lý các tokens đầu vào song song. Trong bài viết này, mình sẽ cố gắng break down từng phép biểu diễn cũng như biến đổi để xây dựng được intuition, nhưng bạn nên tưởng tượng những phép biến đổi đó diễn ra song song trên tất cả tokens. Để làm được điều này, thì chúng ta phải biến đổi tokens thành một dạng số để máy tính có thể xử lý song song hiệu quả.
- (4) LLMs biểu diễn token và xử lý chúng dưới dạng số, cụ thể là ma trận số. Nếu prompt của bạn có 100 từ (100 tokens), thì mỗi token sẽ được số hóa thành 1 embedding vector. Mỗi embedding vector sẽ có độ dài 8192 con số, và thứ Transformer sẽ xử lý đầu vào là một ma trận chứa các embedding vector này, với chiều không gian là 100 x 8192.
- Ma trận này chính là thứ sẽ được Transformer tính toán biến đổi, để cuối cùng ở đầu ra sẽ là 1 embedding vector có độ dài 8192. Vector này sẽ được chuyển về lại thành dạng token mà con người đọc hiểu được - đây chính là những câu từ bạn thường thấy ChatGPT, Claude hay Gemini output ra. Trong câu chuyện trên, mình có nhắc đến embedding vector, đó là gì?
- (5) Embedding vector là dạng biểu diễn số của một token trong không gian đa chiều. Càng đi xuống bản chất ở tầng thấp nhất của máy tính, chúng ta càng thấy tất cả chỉ là những con số. Nếu token là một từ trong câu, thì nó cần được biến đổi thành dạng số theo một cách nào đó để LLM có thể xử lý được. Đây là lý do tại sao chúng ta phải biến token thành embedding vector.
- Cơ chế để biến token thành embedding vector thì có nhiều, nhưng thứ quan trọng cần hiểu, đó là các embedding vector cho token không nằm ở tọa độ ngẫu nhiên. Vị trí tương đối của chúng trong không gian đa chiều đều có ý nghĩa.
- Thí dụ: embedding vector biểu diễn token "Coffee" sẽ gần với embedding vector cho token "Trà" hơn là embedding với vector cho token "Mèo." Với cùng một mô hình LLM, thì một token lúc nào cũng sẽ chỉ tương ứng với một embedding vector.
- Nếu khoảng cách giữa 2 vectors nó có ý nghĩa, thì làm thế nào thể hiện được khoảng cách này dưới dạng toán học? Chúng ta có thể dùng:
- Cơ chế để biến token thành embedding vector thì có nhiều, nhưng thứ quan trọng cần hiểu, đó là các embedding vector cho token không nằm ở tọa độ ngẫu nhiên. Vị trí tương đối của chúng trong không gian đa chiều đều có ý nghĩa.
- (6) Dot Product thể hiện độ tương đồng (similarity) của 2 vectors. dot product (thường thể hiện trong phương trình bằng dấu chấm) đo đạc mức độ giống nhau của 2 vectors trong không gian đa chiều. Lấy lại ví dụ trên, dot product của vector cho token "Coffee" và vector cho token "Trà" sẽ cao hơn là dot product giữa "Coffee" và "Mèo". Kết quả của dot product là một con số gọi là similarity score.
- (7) LLMs mã hóa các pattern học được từ dữ liệu dưới dạng ma trận số. Không chỉ token đầu vào được diễn tả dưới dạng vector chứa những con số như trên, mà Transformer còn phải học được những pattern từ dữ liệu training. Các pattern này cũng được trữ dưới dạng những ma trận con số.
- Về bản chất có thể xem Transformer là một cỗ máy thực hiện các phép biến đổi hình học để biến một ma trận con số (là những tokens đầu vào) thành một ma trận con số 1 cột (a.k.a vector), chính là token Transformer dự đoán tiếp theo.
Không chỉ các token đầu vào được biểu diễn dưới dạng vector số, mà trong quá trình huấn luyện, Transformer còn học được cách biến đổi những vector này thông qua hàng tỷ tham số được mã hóa trong các ma trận trọng số.
Nhìn từ một góc độ trực giác, Transformer có thể được xem như một cỗ máy thực hiện liên tiếp các phép biến đổi hình học trên không gian vector. Nó nhận vào một ma trận gồm các embedding vectors của những token trong câu, rồi từng bước biến đổi chúng thành những biểu diễn ngày càng giàu ngữ cảnh hơn.
Khi đi qua lớp Transformer cuối cùng, mỗi token sẽ sở hữu một vector biểu diễn đã hấp thụ thông tin từ những token xung quanh. Vector tương ứng với token cuối cùng sau đó được sử dụng để tính toán xác suất xuất hiện của token tiếp theo trong từ vựng.
Tổng quan về Transformer
LLMs, mà cụ thể là Transformer, mã hóa patterns học được từ dữ liệu dưới dạng các ma trận. Các con số trong ma trận này được tinh chỉnh trong quá trình training để mã hóa được các pattern về khái niệm, nhân quả nằm chìm bên trong ngôn ngữ của loài người. Các ma trận này chính là thứ Transformer sẽ sử dụng để biến đổi các token đầu vào, rồi xử lý chế biến chúng để output ra token tiếp theo.
Có hai dạng biến đổi chính ở trong kiến trúc Transformer:
- (1) Attention tìm kiếm và hòa tan thông tin từ các tokens liên quan vào một token. Thí dụ, vector cho token "trời" trong câu "Trời ơi!" và token "trời" trong câu "Bầu trời hôm nay xanh quá" ban đầu là giống nhau (đều là 1 embedding vector), nhưng thông qua cơ chế Attention, vector trong hai câu đó sẽ trở nên rất khác nhau do ngữ cảnh của các tokens liên quan cũng khác nhau. Attention biến một token embedding vector thành một token vector khác có nhiều thông tin hơn đến từ ngữ cảnh.
- (2) Feed-Forward Network (FFN) sử dụng output vector của Attention, rồi tìm kiếm và kích hoạt những khái niệm liên quan mà LLM đã học được (các khái niệm hay mối liên hệ này là các ma trận trọng số đã được học trong quá trình huấn luyện). Thí dụ, với cùng một token "trời", FFN sẽ truy xuất được các khái niệm về thời tiết trong câu "Bầu trời hôm nay xanh quá", hoặc khái niệm về cảm thán trong câu "Trời ơi!".
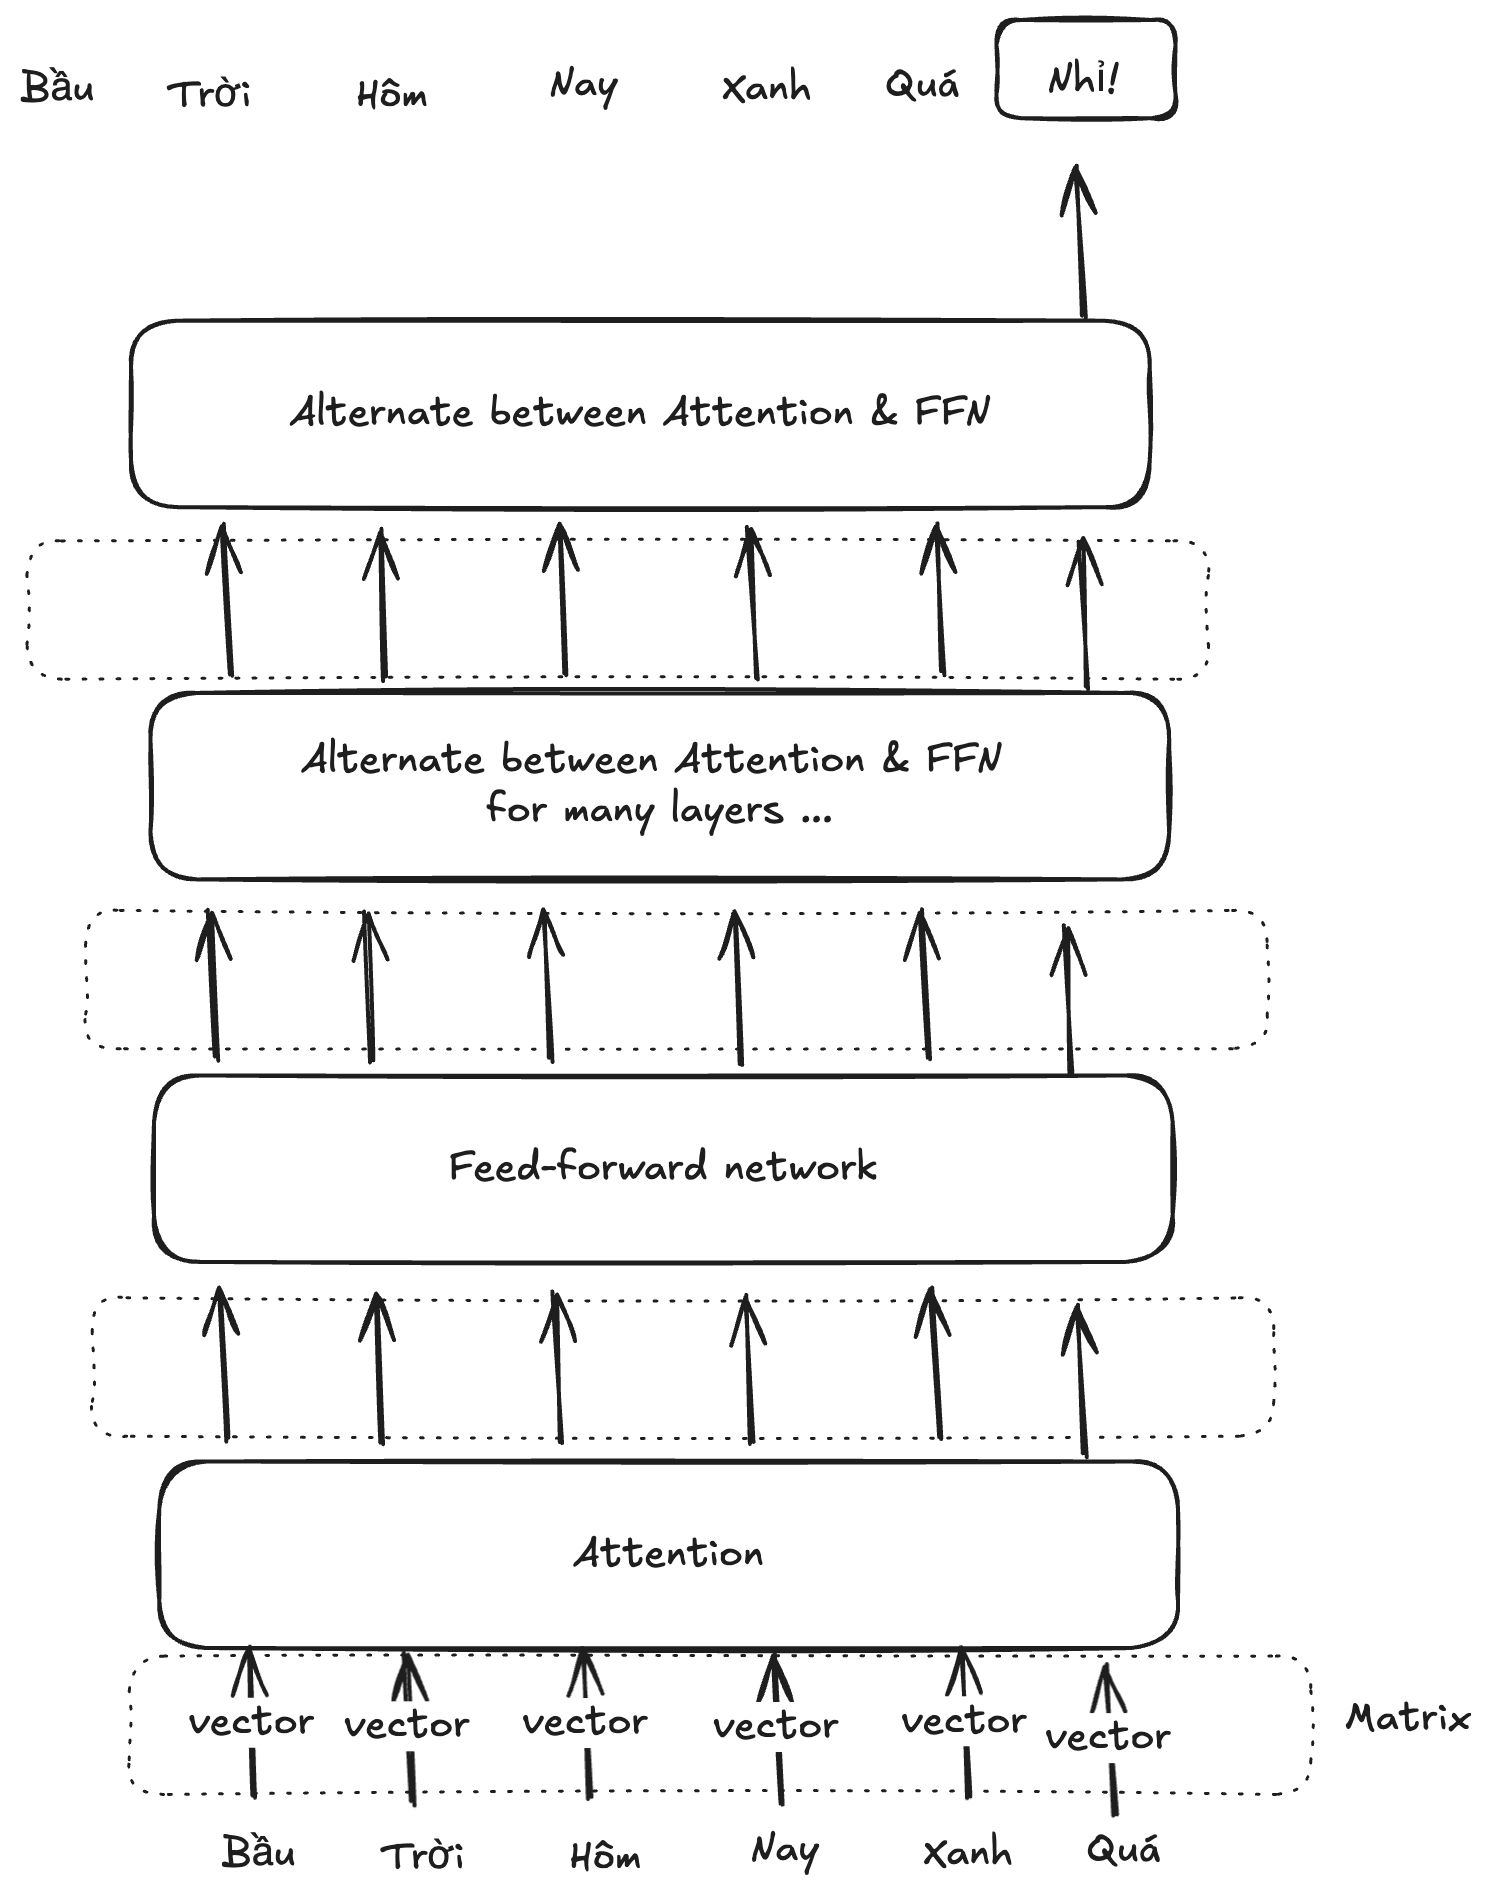
Hai dạng biến đổi này đan xen nhau: token vector đi qua Attention sau đó được biến đổi tiếp bằng FFN, thông qua nhiều lớp như vậy để cuối cùng output ra được một token vector đại diện cho token tiếp theo mà Transformer dự đoán.
Vậy Attention và Feed-Forward Network hoạt động như thế nào? Hãy đi vào cơ chế Attention trước, vì đây là phần có lẽ sẽ phức tạp nhất để xây dựng được intuition. Khi chúng ta qua được quả núi này rồi, thì phần FFN có thể sẽ dễ hiểu hơn một chút (một chút thôi 😁).